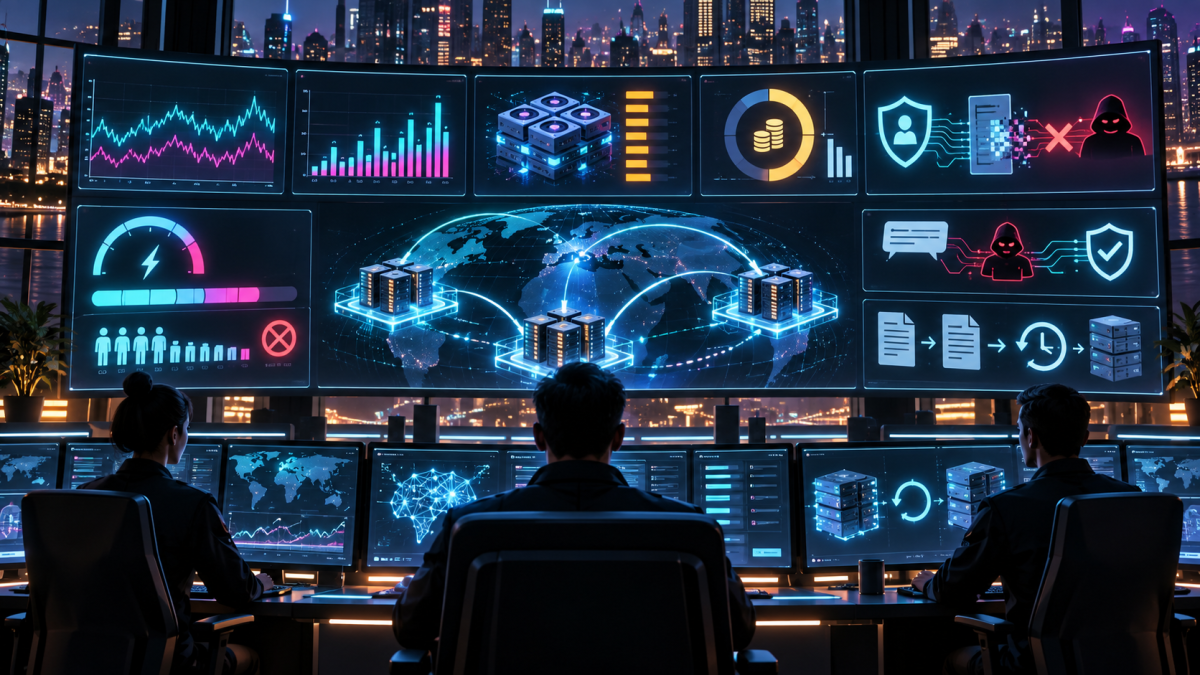
本文把一个已经能回答问题的 LLM 应用提升为可运营平台:明确网关、编排、检索、模型和工具边界;建立质量与运行 SLO;完成追踪、容量、成本、安全、灰度、降级和故障演练。目标是出现问题时能在十分钟内回答“影响谁、哪一层、哪个版本、如何止损”。
1. 划分平台组件与责任
- API 网关:身份、租户、TLS、限流、请求大小和 trace_id。
- 编排层:模型路由、提示模板、RAG、工具与策略。
- 推理层:只执行模型,不持有高权限业务数据库凭据。
- 数据层:文档、向量、缓存、版本和 ACL。
- 观测层:metrics、traces、logs、评测与审计。
每个组件有健康检查、超时、负责人和降级路径。不要把所有职责塞进一个聊天服务。
2. 同时定义运行 SLO 与质量 SLO
| 类别 | 示例指标 | 意义 |
|---|---|---|
| 可用性 | 符合业务响应契约的请求比例 | HTTP 200 但空答案不算成功 |
| 交互性能 | TTFT、TPOT、P95/P99、队列 | 区分排队、prefill 和 decode |
| 质量 | 任务成功、忠实度、引用、拒答 | 固定探针集+线上抽样 |
| 安全 | 越权、泄漏、注入成功 | 关键违规目标应为 0 |
| 成本 | 单位成功任务成本 | 比每 token 单价更接近业务 |
分别为交互、批处理和高风险路由设目标。写清统计窗口、排除项、数据源和错误预算。
3. 建立端到端 Trace
request span
├── authenticate_and_authorize
├── retrieval
│   ├── dense_search
│   ├── sparse_search
│   └── rerank
├── prompt_assembly
├── model_generation
├── citation_validation
└── tool_execution (optional)
span 记录 model revision、prompt version、index version、输入/输出 token、检索文档 ID、策略结果和错误码。原始问题、文档正文和模型输出可能含 PII,默认不记录或先脱敏。trace_id 用于日志关联,不做指标标签。
4. 设计低基数指标
llm_requests_total{route,model,status}
llm_request_duration_seconds_bucket{route,model}
llm_ttft_seconds_bucket{route,model,input_bucket}
llm_tpot_seconds_bucket{route,model}
llm_tokens_total{route,model,direction}
llm_queue_depth{model_pool}
rag_retrieval_duration_seconds_bucket{index_version}
rag_citation_validation_total{result}
agent_tool_calls_total{tool,result}
llm_policy_decisions_total{policy,result}
不要把 user_id、prompt、trace_id 放入 Prometheus 标签,避免高基数。时长单位按 OpenTelemetry 约定使用秒。仪表盘从端到端延迟下钻到队列、检索、模型、工具和 GPU。
5. 构建可行动的告警
| 现象 | 先看 | 第一动作 |
|---|---|---|
| TTFT 上升 | queue_ms、输入长度、并发 | 限流/扩容,隔离长请求 |
| TPOT 上升 | GPU 利用率、温度、batch | 检查降频与调度变化 |
| 质量下降 | 模型/提示/索引版本 | 停止灰度并重跑固定集 |
| 成本激增 | token、重试、Agent 循环 | 定位路由与租户,限制预算 |
| 引用下降 | 索引、检索与校验 | 切回旧索引或拒答 |
使用多窗口错误预算告警,避免瞬时波动造成告警风暴。每条告警链接到运行手册。
6. 用真实流量分布做容量压测
- 从脱敏流量统计输入/输出 token 的 P50、P90、P99 与路由比例。
- 固定模型、模板和索引,预热缓存。
- 从低到达率逐级加压,每阶段持续足够时间。
- 记录 TTFT、TPOT、队列、错误、GPU、显存、功耗。
- 找到尾延迟快速恶化的拐点,安全容量取其下方并留 N-1 余量。
docker stats --no-stream
nvidia-smi --query-gpu=timestamp,index,utilization.gpu,memory.used,temperature.gpu,power.draw --format=csv
curl -fsS http://localhost:9090/api/v1/query?query=llm_queue_depth
不要只用“你好”或固定短请求,也不要只写“支持 20 并发”。容量结论要绑定 GPU、镜像、模型、上下文和长度分布。
7. 计算单位成功任务成本
月成本 = GPU实例小时 + CPU/内存 + 向量库 + 存储 + 网络 + 外部API + 运维
单位成功任务成本 = 月总成本 / 成功完成业务任务数
GPU有效利用率 = 实际prefill与decode时间 / GPU可用时间
按租户、路由、模型统计输入/输出 token、重试和失败。先清理无效重试、无限 Agent 循环、过长上下文和错误缓存,再考虑量化或换模型。便宜但任务失败的请求会提高单位成功成本。
8. 正确设计缓存
只有稳定、非敏感、权限一致的结果才适合缓存。缓存键至少包含租户/权限摘要、模型、提示模板、索引、规范化问题和影响答案的参数。文档权限或版本变化要使相关缓存失效。
key = sha256(json.dumps({
    "tenant": tenant_id,
    "acl": sorted(role_ids),
    "model": model_revision,
    "prompt": prompt_version,
    "index": index_version,
    "question": normalized_question,
    "temperature": temperature,
}, sort_keys=True).encode()).hexdigest()
不得跨租户共用仅按问题文本生成的缓存键。
9. 安全控制与数据治理
网关执行认证和限流;检索执行 ACL;工具执行器实行最小权限、审批和幂等;输出进入 HTML、SQL、Shell、邮件前使用对应校验/编码;镜像和模型制品固定哈希并做供应链管理。外部模型调用前确认数据地域、保留和训练使用条款。
10. 灰度发布与自动回滚
- 构建不可变制品,记录代码、模型、模板、索引和策略版本。
- 离线跑质量、红队和性能门禁。
- 预发布做真实依赖集成。
- 影子流量只比较,不影响用户。
- 按租户或比例灰度,观察完整 SLO。
- 满足观察窗口后全量。
错误预算快速消耗、关键质量下降、安全违规、成本或 P95 超阈值时自动停止并回退整个版本组合,不能只回滚模型却保留新模板和索引。
11. 设计诚实的降级
| 故障 | 允许的降级 | 禁止 |
|---|---|---|
| 主模型拥塞 | 切换通过质量门禁的小模型 | 静默换未评测模型 |
| 向量库故障 | 高风险问答明确资料不可用 | 绕过证据凭记忆回答 |
| 重排超时 | 使用已评测的基础召回 | 无界等待 |
| 工具不可用 | 返回可重试状态或人工流程 | 假装执行成功 |
| 审计不可用 | 暂停高风险写操作 | 失去记录仍自动执行 |
12. 完成三类故障演练
GPU 实例丢失:终止一个实例,确认负载均衡摘除、剩余容量受控、在途请求按策略失败或重试,恢复后经 smoke 才接流量。
错误索引发布:切到缺少文档的候选索引,确认固定探针阻止全量;把别名切回旧索引并验证缓存和引用恢复。
提示注入:发送越权与伪造工具指令,确认策略阻断、无副作用、日志脱敏并产生安全事件。
13. 值班人员的前十分钟
- 确认影响范围、路由、租户和开始时间。
- 冻结相关发布,检查最近模型/模板/索引变更。
- 比较错误、TTFT、TPOT、队列和依赖健康。
- 按预案限流、降级或回滚,先止损。
- 保存 trace 和最小复现,避免无证据重启全部服务。
- 恢复后用固定探针验证,再逐步放量。
14. 总结
生产级 LLM 平台必须同时管理质量、性能、安全与成本。只有版本可追踪、指标可行动、容量经过真实压测、降级保持诚实并定期演练,系统才具备长期运行能力。