一、为什么普通“抽文本再切块”会失败
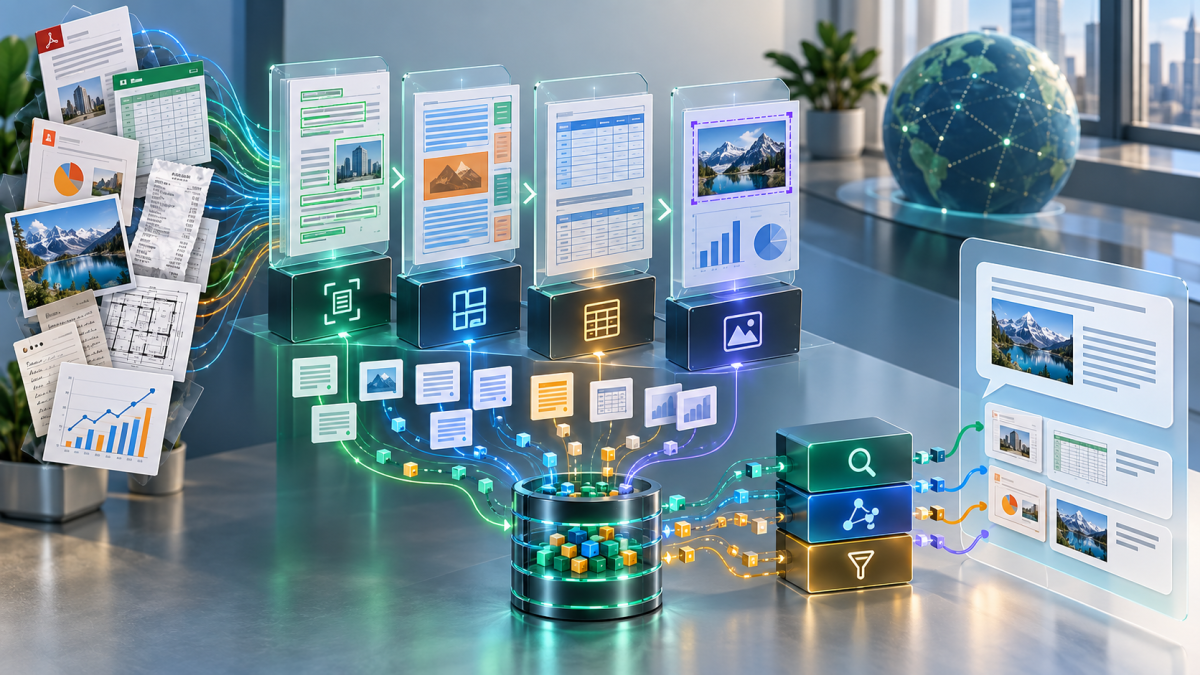
企业资料不仅有段落,还包含表格、页眉页脚、扫描页、图片、公式和跨页结构。若只按字符抽取,表头与单元格会错位,图片失去语义,页码和章节也无法追溯。本文用 Docling 解析 PDF、DOCX、PPTX、XLSX 和图片,保留布局与来源元数据,再建立可引用的多模态 RAG。
documents -> malware/type check -> Docling layout/OCR/table parsing
 -> normalized document JSON + artifacts
 -> structure-aware chunks + stable IDs + page/section metadata
 -> dense/sparse indexes -> retrieve -> rerank -> grounded answer
 -> citations -> evaluation -> feedback and re-index
二、环境与可复现目录
python -m venv .venv
. .venv/bin/activate
python -m pip install --upgrade pip
pip install docling qdrant-client sentence-transformers fastapi uvicorn pydantic
pip freeze > requirements.lock
mkdir -p data/inbox data/quarantine data/normalized data/artifacts index tests
首次实验可以使用当前稳定版;进入生产前必须把 requirements.lock 提交评审并在隔离环境验证。OCR 与模型权重应提前下载到内部制品库,避免运行时访问公网导致不可复现。
三、入口安全:先确认文件,再解析
- 按文件签名识别类型,不相信扩展名;限制单文件大小、页数、解压后总大小和处理时长。
- 在隔离容器中做恶意文件扫描,禁止宏、外部链接抓取和任意路径写入。
- 为原文件计算 SHA-256,生成 document_id;同一哈希不重复解析。
- 原文件只读保存,解析结果写新目录;失败文件进入 quarantine 并保留错误原因。
from hashlib import sha256
from pathlib import Path

def file_sha256(path: Path) -> str:
    h = sha256()
    with path.open('rb') as f:
        for block in iter(lambda: f.read(1024 * 1024), b''):
            h.update(block)
    return h.hexdigest()
四、使用 Docling 解析并保存规范化结果
from pathlib import Path
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def convert_one(source: Path, out_dir: Path):
    result = converter.convert(source)
    doc = result.document
    stem = source.stem
    (out_dir / f'{stem}.md').write_text(doc.export_to_markdown(), encoding='utf-8')
    (out_dir / f'{stem}.json').write_text(doc.export_to_json(), encoding='utf-8')
    return doc

doc = convert_one(Path('data/inbox/handbook.pdf'), Path('data/normalized'))
不要只保存 Markdown。JSON 是重建块、页码、表格和图片引用的权威中间格式;Markdown 用于人工抽查。对扫描件启用 OCR 时,要记录语言、引擎和置信度;低置信页进入人工复核队列。
五、结构化切块:标题、表格和图片分别处理
段落按章节路径聚合,并设置软上限;表格保留表名、表头、单位和行范围,过宽表按行分组但重复表头;图片保存资产 ID、页码、附近标题和可审核说明。块 ID 由 document_id、版本、页码、结构路径和内容哈希生成,更新时才能精准删除旧块。
{
  "chunk_id": "sha256:...",
  "document_id": "policy-2026-09",
  "version": 4,
  "source_sha256": "...",
  "page_start": 17,
  "page_end": 18,
  "section_path": ["费用管理", "差旅标准"],
  "block_type": "table",
  "table_headers": ["城市等级", "住宿上限", "币种"],
  "text": "一线城市 | 800 | CNY ...",
  "acl": ["group:finance", "group:employees"],
  "source_uri": "s3://knowledge/policy-v4.pdf"
}
import hashlib, json
def stable_chunk_id(c):
identity = {
'document_id': c['document_id'], 'version': c['version'],
'page_start': c['page_start'], 'section_path': c['section_path'],
'block_type': c['block_type'], 'text': c['text']
}
raw = json.dumps(identity, ensure_ascii=False, sort_keys=True).encode()
return hashlib.sha256(raw).hexdigest()六、嵌入、索引与 ACL
选择支持中文并与业务语料匹配的嵌入模型,固定模型名、版本和向量维度。任何更换都写入新集合。ACL 必须在检索阶段过滤,不能先取回敏感块再让模型“不要回答”。
from qdrant_client import QdrantClient, models
from sentence_transformers import SentenceTransformer

MODEL_NAME = 'BAAI/bge-m3'
COLLECTION = 'enterprise_docs_bge_m3_v1'
model = SentenceTransformer(MODEL_NAME)
client = QdrantClient(url='http://qdrant:6333', api_key='REPLACE_ME')

client.create_collection(
    collection_name=COLLECTION,
    vectors_config=models.VectorParams(size=model.get_sentence_embedding_dimension(),
                                       distance=models.Distance.COSINE),
)

vectors = model.encode([c['text'] for c in chunks], normalize_embeddings=True)
client.upsert(COLLECTION, points=[
    models.PointStruct(id=c['chunk_id'], vector=v.tolist(), payload=c)
    for c, v in zip(chunks, vectors)
])
示例为全新集合。实际代码应先检查集合是否存在,并为 document_id、version、acl、block_type 和 page_start 创建 payload index。不要在生产请求中自动创建或重建集合。
七、检索、重排与上下文组装
def retrieve(question: str, allowed_acl: list[str], limit=30):
    query = model.encode(question, normalize_embeddings=True).tolist()
    hits = client.query_points(
        collection_name=COLLECTION,
        query=query,
        query_filter=models.Filter(must=[
            models.FieldCondition(key='acl', match=models.MatchAny(any=allowed_acl))
        ]),
        limit=limit,
        with_payload=True,
    ).points
    deduped = deduplicate_overlapping_chunks(hits)
    reranked = cross_encoder_rerank(question, deduped)
    return assemble_context(reranked[:8], max_tokens=6000,
                            preserve_tables=True, include_citations=True)
检索先扩大候选,再用 reranker 重排。上下文组装按章节邻接合并,避免同一表格被拆散;同时去除高度重叠块,按 token 预算截断。若权限过滤后证据不足,应返回“资料不足”,而不是降低过滤条件。
八、生成必须带可核验引用
System rules:
1. Only answer from supplied evidence.
2. Every material claim must cite [document_id p.page].
3. Preserve units, dates and table headers exactly.
4. If evidence conflicts, show both sources and versions.
5. If evidence is insufficient, state what is missing; do not infer.
模型返回后还要做引用校验:引用的 chunk 必须在本次检索集合中,页码必须存在,引用句与证据需有足够文本蕴含。对金额、日期和比例做确定性比对;不通过时拒绝发布答案并记录失败样本。
九、端到端评测与故障定位
- 解析:页数、标题层级、表格行列、OCR 字符错误率、图片数量与人工基准对比。
- 检索:Recall@k、MRR、ACL 泄漏率、旧版本命中率、表格问题命中率。
- 回答:faithfulness、context precision/recall、引用准确率、拒答正确率。
- 运行:解析耗时、嵌入吞吐、检索 P95、生成成本、失败队列和重试次数。
pytest -q tests/test_parser_contract.py
pytest -q tests/test_acl_retrieval.py
python -m tools.eval_retrieval --dataset tests/golden.jsonl --k 5,10,30
python -m tools.eval_answers --dataset tests/golden.jsonl --require-citations
常见错误要分层:原文就不可读属于输入问题;解析后表格错位属于解析问题;正确块未进入 top-k 属于检索问题;证据正确但答案错误属于生成问题。只有分层记录中间产物,才不会把所有问题都归因于模型。
十、增量更新、删除与备份
- 新文件进入隔离区,计算哈希并解析到新版本,不覆盖旧版本。
- 完成解析与检索评测后原子切换 active_version。
- 按 document_id + old version 删除旧向量,同时保留审计事件。
- 删除请求必须清理原文件、派生图片、规范化 JSON、缓存和向量,并验证检索不到。
- 定期备份向量数据库与元数据;从原文件全量重建一次,验证灾难恢复步骤。
十一、总结
多模态 RAG 的难点不在“把更多格式丢给模型”,而在保留结构、来源、版本和权限。以 Docling 生成可审计的中间表示,用稳定块 ID 和 ACL 构建索引,再通过重排、引用校验和分层评测建立闭环,才能让 PDF、表格、图片和扫描件真正变成可信知识。