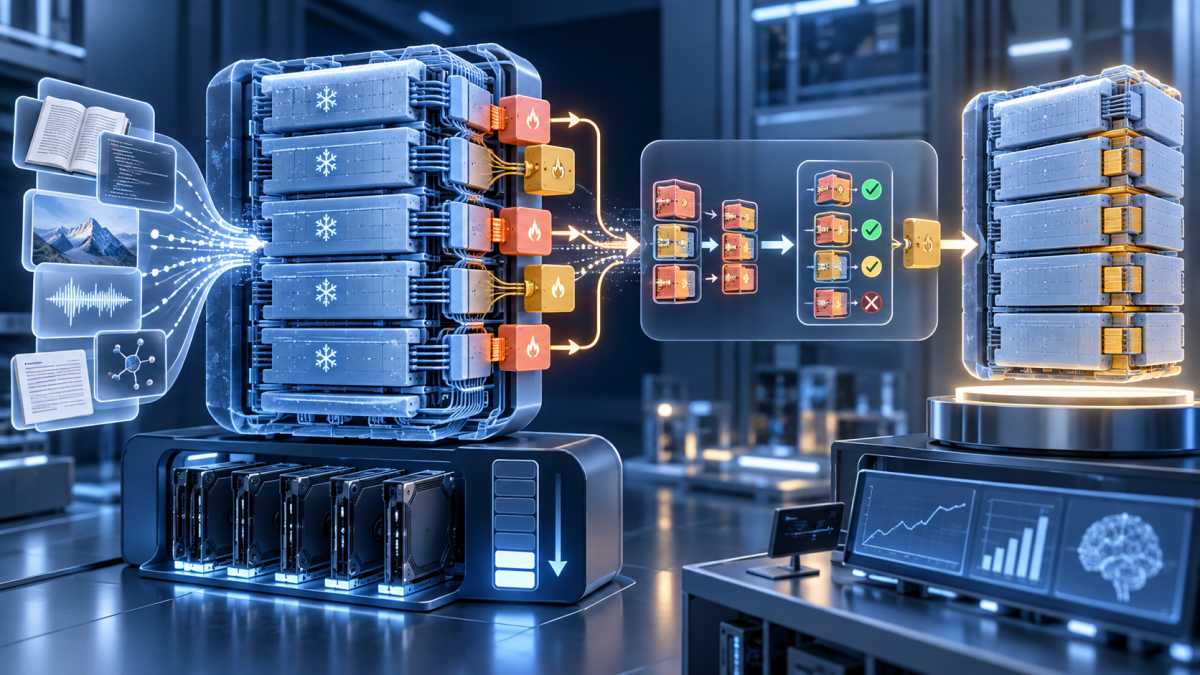
本文以监督微调为例,完成数据准备、LoRA/QLoRA 配置、TRL SFT 训练、独立测试、Adapter 发布与回滚。目标不是让 loss 尽量低,而是在固定业务测试集上相对基础模型获得可解释收益,同时不降低事实性、安全和拒答能力。
1. 先判断是否应该微调
动态知识缺失优先 RAG;JSON 偶尔不合法先用结构化输出;只有稳定的分类、抽取、风格或任务映射在高质量示例下仍表现不足,才考虑 LoRA。微调前保存 base+prompt 和 base+RAG 基线。
2. 准备隔离环境与版本锁
python3 -m venv .venv
. .venv/bin/activate
pip install --upgrade pip
pip install transformers peft trl datasets accelerate bitsandbytes
pip freeze > requirements-lock.txt
nvidia-smi
实际项目应根据 Hugging Face 当前兼容矩阵锁定版本。模型和数据许可必须允许用途,访问 token 通过 secret 注入。
3. 构建可审计数据集
{"id":"ticket-0001","source":"approved-annotation-v3","messages":[{"role":"system","content":"把工单归一为 JSON。"},{"role":"user","content":"支付回调持续超时"},{"role":"assistant","content":"{\"system\":\"payment\",\"severity\":\"high\"}"}]}删除密码、个人信息、重复样本、占位回答和无法确认来源的数据。按文档来源或时间切分 train/validation/test,避免同文档近重复内容跨集合。测试集不能用于挑超参数。
import json
from collections import Counter
rows = [json.loads(x) for x in open("all.jsonl", encoding="utf-8")]
ids = set(); lengths = []
for row in rows:
    assert row["id"] not in ids; ids.add(row["id"])
    assert row["messages"][-1]["role"] == "assistant"
    assert all(m["content"].strip() for m in row["messages"])
    lengths.append(sum(len(m["content"]) for m in row["messages"]))
print("samples", len(rows), "max_chars", max(lengths))
再做语义近重复和敏感信息扫描,并由领域人员抽查。
4. 加载 4-bit 基础模型
下面是 QLoRA 的常见结构。model_id、revision 和 dtype 按已批准模型与 GPU 调整。不是所有硬件都支持 bf16。
import torch
from peft import prepare_model_for_kbit_training
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "your-approved-model"
REVISION = "fixed-revision"
bnb = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, revision=REVISION)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    revision=REVISION,
    quantization_config=bnb,
    device_map="auto",
)
model = prepare_model_for_kbit_training(model)
先对一条 messages 应用 chat template 并解码,确认角色、结束符和 assistant 区域正确。模板错误时 loss 仍可能下降。
5. 配置 LoRA 并确认可训练参数
from peft import LoraConfig

peft_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
)
target_modules 必须根据模型模块名称确认,不能机械复制。r 控制容量,alpha 控制缩放,dropout 用于正则。先从较小容量起步。
6. 先做 20 条样本的管道验证
正式训练前用 20 条已确认样本跑短训练,验证数据、mask、梯度、保存和加载。这个 checkpoint 不用于生产。
trainable = [(n, p.numel()) for n, p in model.named_parameters() if p.requires_grad]
print("trainable tensors:", len(trainable))
print("trainable params:", sum(size for _, size in trainable))
assert trainable, "LoRA adapter was not attached"
小样本不能拟合时,先检查 labels 是否全为 -100、chat template、可训练参数和学习率,不要直接扩大 r。
7. 用 TRL SFTTrainer 训练
from datasets import load_dataset
from trl import SFTConfig, SFTTrainer

dataset = load_dataset("json", data_files={
    "train":"train.jsonl", "validation":"validation.jsonl"})
args = SFTConfig(
    output_dir="outputs/lora-v1",
    num_train_epochs=2,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    learning_rate=1e-4,
    logging_steps=10,
    eval_strategy="steps",
    eval_steps=100,
    save_steps=100,
    load_best_model_at_end=True,
    max_length=2048,
    assistant_only_loss=True,
)
trainer = SFTTrainer(
    model=model, args=args, train_dataset=dataset["train"],
    eval_dataset=dataset["validation"], peft_config=peft_config)
trainer.train()
trainer.save_model("outputs/lora-v1/final-adapter")
参数名以锁定 TRL 版本为准。assistant_only_loss 要求 chat template 能产生正确 assistant mask。记录 loss、eval loss、learning rate、grad norm、token accuracy、吞吐和峰值显存。
8. 处理 OOM 和过拟合
| 问题 | 优先处理 | 代价 |
|---|---|---|
| 前向 OOM | 减 max_length 或 per-device batch | 上下文覆盖/吞吐下降 |
| 反向 OOM | 梯度检查点、梯度累积 | 训练变慢 |
| 加载 OOM | QLoRA、offload、更小模型 | 速度和质量需复测 |
| train 降、eval 变差 | 早停、清洗数据、降容量 | 可能需要更多高质量样本 |
训练 loss 不是业务指标。格式提升但事实性或拒答下降时不能发布。
9. 在独立测试集上比较
使用完全相同的模板和解码参数比较 base、base+prompt、base+RAG、base+LoRA。分类报告宏 F1 和混淆矩阵;抽取报告字段 F1 和 Schema 通过率;生成任务做盲审。加入长输入、无答案、恶意指令和训练未覆盖表述。
from peft import PeftModel

base = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    revision=REVISION,
    quantization_config=bnb,
    device_map="auto",
)
model = PeftModel.from_pretrained(base, "outputs/lora-v1/final-adapter")
inputs = tokenizer.apply_chat_template(
    TEST_MESSAGES,
    add_generation_prompt=True,
    return_tensors="pt",
).to(model.device)
out = model.generate(inputs, max_new_tokens=256, do_sample=False)
print(tokenizer.decode(out[0][inputs.shape[-1]:], skip_special_tokens=True))
逐样本保存基础模型和 Adapter 输出;总体提升不能掩盖高风险分组退化。
10. 发布 Adapter 与回滚
优先保持基础模型与 Adapter 分离,记录 base revision、tokenizer、chat template、PEFT 配置、数据集哈希和依赖锁。若必须合并权重,输出到新目录并重复完整测试,不覆盖原基础模型。
merged = model.merge_and_unload()
merged.save_pretrained("artifacts/model-merged-v1", safe_serialization=True)
tokenizer.save_pretrained("artifacts/model-merged-v1")
灰度发布并保留路由切回上一 Adapter 或基础模型。模型卡写明用途、禁止用途、数据来源、硬件、评测、偏差和已知失败。
11. 总结
高质量微调始于正确的问题选择和数据治理,而不是训练参数。只有 Adapter 在独立测试集上稳定优于基线、关键安全指标不退化、制品可追踪并可回滚,才算完成。