一、为什么需要独立 AI Gateway
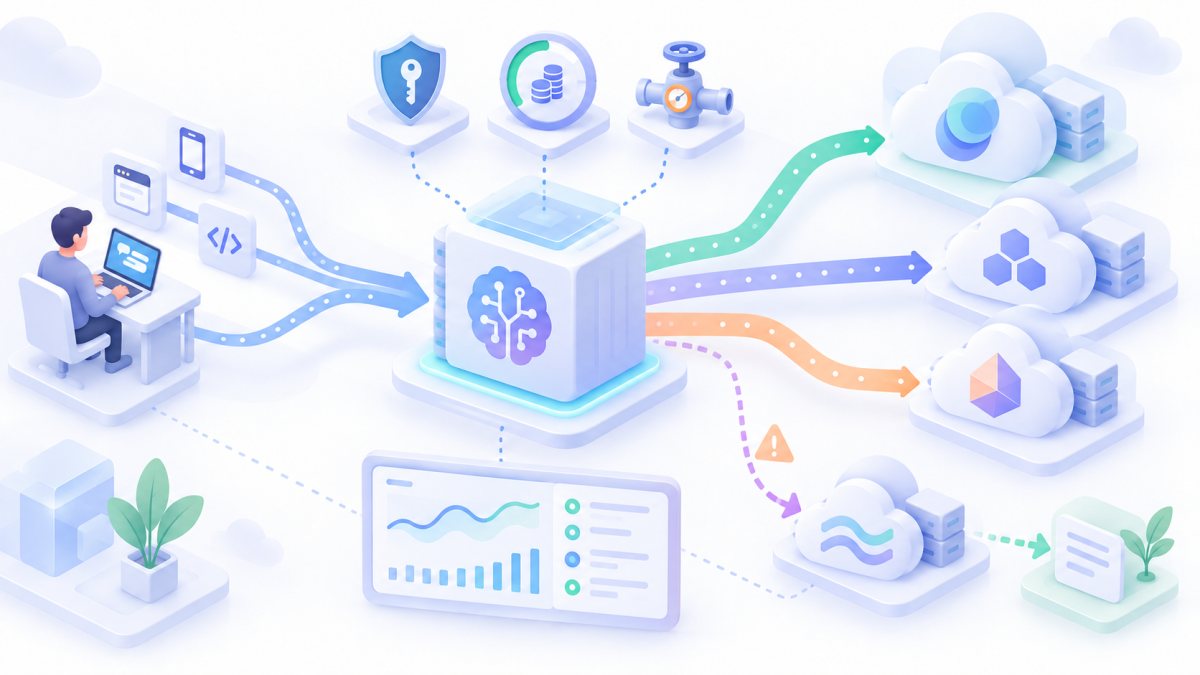
当应用同时使用多个大模型提供商或自托管模型时,直接在每个服务中实现鉴权、路由、重试、预算和日志会快速失控。AI Gateway 统一 OpenAI 兼容接口,把供应商差异、虚拟密钥、配额、fallback、成本和审计集中治理。
Applications / Agents
        | virtual key + tenant metadata
        v
   LiteLLM Proxy
   |-- auth / rate limit / budget
   |-- weighted routing / retry / fallback
   |-- guardrails / audit / metrics
   +--------+---------+----------+
            v         v          v
       Model A    Model B    Self-hosted Model
本文使用 LiteLLM Proxy 构建生产基线。具体版本需固定到已验证镜像 digest;本文不把“所有请求都成功”当目标,而是保证错误有界、成本可控、降级可解释。
二、定义模型别名和业务 SLO
应用只依赖稳定别名,例如 chat-standard、chat-premium、embedding-default,不要把供应商模型名散落在代码中。为每个别名定义质量、延迟、可用性、上下文长度、区域和成本上限。
| 别名 | 场景 | P95 | 可用性 | 降级 | | --- | --- | --- | --- | --- | | chat-standard | FAQ/摘要 | 3s | 99.9% | 同级备用 | | chat-premium | 复杂推理 | 12s | 99.5% | standard + 提示 | | embedding-default | RAG 入库 | 800ms | 99.9% | 暂停写入 |
Embedding 不能随意 fallback 到不同维度或语义空间,否则已有向量索引失效。
三、用 Secret 启动数据库与 Proxy
生产部署需要持久数据库保存虚拟密钥、预算和消费记录。示例使用 Docker Compose 展示结构,不在 YAML 写真实 API Key。
services:
  db:
    image: postgres:18
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD_FILE: /run/secrets/db_password
    secrets: [db_password]
    healthcheck:
      test: [CMD-SHELL, "pg_isready -U litellm -d litellm"]
      interval: 5s
      timeout: 3s
      retries: 30
  gateway:
    image: ghcr.io/berriai/litellm:REPLACE_WITH_PINNED_VERSION
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    volumes:
      - ./config.yaml:/app/config.yaml:ro
    environment:
      DATABASE_URL: postgresql://litellm:REPLACE_AT_RUNTIME@db:5432/litellm
      LITELLM_MASTER_KEY_FILE: /run/secrets/master_key
    secrets: [master_key]
    depends_on:
      db: {condition: service_healthy}
secrets:
  db_password: {file: ./secrets/db_password.txt}
  master_key: {file: ./secrets/master_key.txt}
若镜像不原生支持 *_FILE,使用最小入口脚本读取文件后 exec,且确认环境不会被诊断接口暴露。
四、完整模型与路由配置
稳定别名映射到多个部署
模型列表把公共别名映射到多个 deployment。供应商凭据从环境或 Secret 读取。参数名会随版本变化,上线前必须用所固定版本的官方 schema 验证。
model_list:
  - model_name: chat-standard
    litellm_params:
      model: provider-a/model-small
      api_key: os.environ/PROVIDER_A_KEY
      timeout: 25
      max_retries: 0
    model_info:
      id: standard-a-primary
  - model_name: chat-standard
    litellm_params:
      model: provider-b/model-fast
      api_key: os.environ/PROVIDER_B_KEY
      timeout: 25
      max_retries: 0
    model_info:
      id: standard-b-secondary

router_settings:
  routing_strategy: latency-based-routing
  num_retries: 1
  retry_after: 1
  allowed_fails: 2
  cooldown_time: 60
把 provider 内部 retry 设低,避免 SDK retry 与 gateway retry 相乘。总尝试次数必须在请求 deadline 内。
五、Fallback 与内容契约
只在能力和安全边界兼容时降级
Fallback 不是简单换模型。目标模型必须满足工具调用、JSON schema、上下文长度、区域和安全策略。为不同失败类型制定策略:429/5xx 可重试或同级 fallback;400、认证失败和安全拒绝通常不应换模型掩盖。
litellm_settings:
  fallbacks:
    - chat-premium: [chat-standard]
  context_window_fallbacks:
    - chat-standard: [chat-long-context]
  content_policy_fallbacks: []
应用响应应携带实际 deployment、是否降级和原因,但不向终端用户泄露供应商凭据或内部错误。
{
  "model_alias": "chat-premium",
  "served_by": "chat-standard",
  "degraded": true,
  "degrade_reason": "primary_rate_limited"
}
六、虚拟密钥、租户和权限
每个应用/租户使用独立虚拟 key,绑定允许模型、团队、预算、RPM/TPM 和到期时间。禁止所有服务共享 master key。
curl -sS http://gateway:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "key_alias":"support-prod",
    "models":["chat-standard"],
    "max_budget":500,
    "budget_duration":"30d",
    "rpm_limit":300,
    "tpm_limit":200000,
    "duration":"90d",
    "metadata":{"owner":"support","environment":"prod"}
  }'
生成响应只显示一次并存入 Secret Manager。日志和工单只能记录 key alias 或哈希后缀。
七、预算、限流与并发控制
预算是财务护栏,限流是容量护栏,两者都要 fail-closed 还是 fail-open 的明确决策。关键生产调用在计费存储不可用时可设置短暂应急额度,但必须告警和审计。
tenant monthly budget
  -> team daily budget
    -> key RPM / TPM
      -> model deployment concurrency
        -> provider account limit
客户端仍需做并发限制和退避:
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(base_url="https://ai-gateway.example.com/v1", api_key=VIRTUAL_KEY)
semaphore = asyncio.Semaphore(20)

async def ask(messages):
    async with semaphore:
        return await asyncio.wait_for(
            client.chat.completions.create(model="chat-standard", messages=messages),
            timeout=30,
        )
八、请求契约与结构化输出
对 Agent/RAG 任务要求明确 temperature、最大输出、工具 schema 和响应格式。Gateway 可设置默认值,但应用必须知道最终生效参数。
{
  "model": "chat-standard",
  "messages": [
    {"role": "system", "content": "仅根据提供的知识库上下文回答;缺少证据时明确说明。"},
    {"role": "user", "content": "问题与检索上下文"}
  ],
  "temperature": 0.1,
  "max_tokens": 800,
  "response_format": {
    "type": "json_schema",
    "json_schema": {"name": "answer", "schema": {"type": "object"}}
  }
}
不是所有模型都支持相同参数;路由前通过能力元数据过滤,不要依赖供应商静默忽略。
九、隐私、日志与 Guardrail
先做数据分类:公开、内部、敏感、受监管。敏感内容进入允许区域和模型;日志默认不保存完整 prompt/response,只保存长度、token、状态、路由和脱敏后的 trace。
litellm_settings:
  success_callback: [prometheus, otel]
  failure_callback: [prometheus, otel]
  turn_off_message_logging: true
  redact_user_api_key_info: true
Guardrail 是辅助控制,不替代应用授权。工具调用在业务侧仍需参数校验、最小权限和人工审批。
十、指标、日志与 Trace
控制标签基数和敏感数据
按 alias/deployment/status/tenant 低基数维度记录请求、首 token 延迟、总延迟、输入/输出 token、缓存命中、429/5xx、retry、fallback、预算拒绝和估算成本。不要把 user_id、prompt 或完整 key 放进指标标签。
curl -sS http://gateway:4000/health/readiness
curl -sS http://gateway:4000/metrics | rg 'litellm|request|spend|fallback'
processors:
  batch: {}
exporters:
  otlphttp/traces:
    endpoint: https://otel.example.com
service:
  pipelines:
    traces:
      processors: [batch]
      exporters: [otlphttp/traces]
跨应用、Gateway、RAG 检索和工具服务传递 traceparent,才能定位延迟与费用来源。
十一、缓存与语义风险
精确缓存键至少包含模型别名、系统提示版本、消息、温度、工具 schema、响应格式和租户数据边界。跨租户共享 prompt 缓存存在泄漏风险,默认隔离。
cache_key = sha256(canonical_json({
    "tenant": tenant_id,
    "model": model_alias,
    "prompt_version": prompt_version,
    "messages": messages,
    "tools": tools,
    "temperature": temperature,
})).hexdigest()
涉及实时价格、权限、医疗或财务结论的请求不应长期缓存;缓存命中也要保留来源和生成时间。
十二、部署、高可用与数据库
Gateway 无状态副本由负载均衡分发,预算/Key/消费状态放在高可用数据库或缓存。探针区分进程存活和关键依赖就绪。
apiVersion: apps/v1
kind: Deployment
metadata: {name: litellm-gateway}
spec:
  replicas: 3
  strategy: {type: RollingUpdate, rollingUpdate: {maxUnavailable: 0, maxSurge: 1}}
  template:
    spec:
      containers:
        - name: proxy
          image: ghcr.io/berriai/litellm@sha256:REPLACE
          ports: [{name: http, containerPort: 4000}]
          readinessProbe:
            httpGet: {path: /health/readiness, port: http}
          resources:
            requests: {cpu: 500m, memory: 512Mi}
            limits: {cpu: "2", memory: 2Gi}
发布前验证数据库 schema migration 向后兼容,滚动期间新旧 Gateway 能同时工作。
十三、测试矩阵与故障演练
覆盖:主模型成功、429、5xx、超时、上下文超长、无效 key、超预算、RPM/TPM、数据库断连、一个供应商全断、fallback 质量、流式中断和工具 schema 不支持。
curl -sS https://ai-gateway.example.com/v1/chat/completions \
  -H "Authorization: Bearer $VIRTUAL_KEY" \
  -H 'Content-Type: application/json' \
  -d '{"model":"chat-standard","messages":[{"role":"user","content":"health check"}]}'
def test_budget_rejection(client):
    response = client.chat.completions.create(model="chat-standard", messages=[...])
    assert response is not None
    # 独立测试 key 达到预算后,应得到明确、可监控的拒绝,不得偷偷用 master key。
故障演练观察总尝试次数、P99、fallback 比例、成本和恢复时间;确认重试没有把供应商故障放大。
十四、发布、回滚与官方资料
先在影子流量比较新配置的路由、输出质量和费用,再 1%/10%/50% 放量。配置必须版本化、可审计,但凭据不入库。回滚同时恢复镜像与配置,保留请求证据。
docker compose config --quiet
./validate-litellm-config config.yaml
./smoke-models --alias chat-standard,embedding-default
./compare-routing --old config.prev.yaml --new config.yaml
- LiteLLM Proxy、Routing、Virtual Keys/Users、Budget、Observability 和 Release Notes 官方文档。
- OpenTelemetry 语义约定与 Collector 官方文档。
- 各模型供应商的限流、数据使用和结构化输出官方文档。
验收:应用只用别名;每租户独立 key;预算/限流生效;retry/fallback 总次数有界;能力不兼容不会误路由;敏感 prompt 不进入日志;指标无高基数秘密;数据库故障行为明确;配置和镜像都可回滚。