一、目标、边界与最小权限
本章使用 bpftrace、perf 和内核 tracepoint 建立分层诊断流程。示例先在隔离测试机复现,再以有限时间窗口进入生产;eBPF 降低观测成本,但高频探针、无限维度 map 和错误内核字段仍会造成明显负载。
优先选择稳定 tracepoint;只有内核版本锁定且参数签名已验证时才使用 kprobe。权限优先 CAP_PERFMON 与 CAP_BPF 等最小能力,不为方便给长期运行容器授予 privileged。
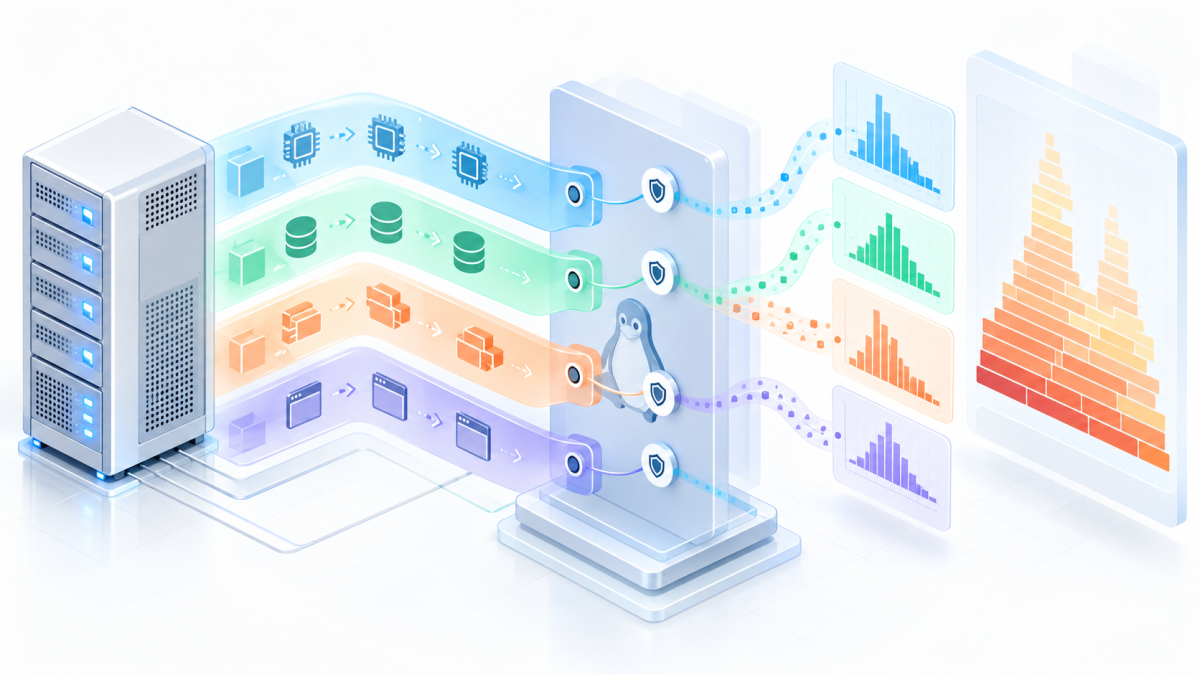
用户请求
├─ 应用:锁、GC、系统调用
├─ CPU:运行队列、切换、热点栈
├─ 磁盘:块延迟、队列、写回
└─ 网络:连接、重传、DNS
    ↓ 时间窗口 + PID/cgroup + 直方图/栈 → 可验证根因
二、安装检查与环境指纹
先确认内核、tracefs、工具版本和可用事件。脚本不能假设所有发行版都有相同探针名;目标事件不存在时停止并重新列出,不要靠修改字段偏移“试出来”。
uname -a
cat /etc/os-release
mount | grep -E 'tracefs|debugfs' || true
sudo bpftrace --info
sudo bpftrace -l 'tracepoint:syscalls:sys_enter_*' | head
sudo perf version
三、先建立不带探针的系统基线
在同一慢请求窗口观察负载、调度、内存、块设备和网络。基线用来选择层级,也用来证明探针自身没有显著改变系统。保存开始时间、持续时间、主机内核、工作负载和构建版本。
date -Is
uptime
vmstat 1 10
pidstat -durw -p ALL 1 10
iostat -xz 1 10
ss -s
nstat -az | head -50
四、CPU:运行队列与热点栈
CPU 高并不等于代码计算慢。先区分用户态、内核态、等待和上下文切换,再对目标进程固定频率采样。火焰图横向宽度是样本占比,不是时间顺序;大量 unknown 往往说明符号或栈展开问题。
TARGET_PID=$(pgrep -n my-service)
sudo perf record -F 99 -g -p "$TARGET_PID" -- sleep 60
sudo perf report --stdio --no-children | head -80

sudo timeout 30 bpftrace -e '
profile:hz:99 { @[kstack] = count(); }
END { print(@, 20); clear(@); }'
五、系统调用:次数与长尾延迟
入口和出口用线程 ID 关联,并在出口 delete 临时 map,避免长时间运行增长。使用直方图观察分布而不是只看平均值,P99 尖峰可能被平均值完全掩盖。
sudo timeout 30 bpftrace -e '
tracepoint:syscalls:sys_enter_read /pid == $1/ { @s[tid] = nsecs; }
tracepoint:syscalls:sys_exit_read /@s[tid]/ {
  @lat_us = hist((nsecs - @s[tid]) / 1000); delete(@s[tid]);
}' "$TARGET_PID"
六、磁盘:排队、服务时间与应用等待
高 await 可能来自设备、队列、限速、写回或虚拟化。把块层延迟与应用 read/write 延迟、设备利用率和队列深度放到同一时间轴,才能判断问题位于文件系统、块层还是硬件。
command -v biolatency-bpfcc || command -v biolatency
sudo timeout 60 biolatency-bpfcc -D 1 10
sudo bpftrace -l 'tracepoint:block:block_rq_*'
iostat -xz 1 30
pidstat -d 1 30
七、网络:连接、丢包与 TCP 重传
重传是现象而不是根因。发现重传后继续检查接收端丢包、MTU、拥塞、连接跟踪表、负载均衡和应用超时。跨主机分析先统一时钟,否则事件顺序会误导判断。
ss -s
ss -tinp
ip -s link
nstat -az | grep -E 'TcpRetransSegs|TcpExtTCPTimeouts'
sudo bpftrace -l 'tracepoint:tcp:*retrans*'
sudo timeout 60 bpftrace -e 'tracepoint:tcp:tcp_retransmit_skb { @[comm] = count(); }'
八、生成火焰图并做等条件对比
优化前后使用相同负载、时长、采样频率和构建符号,同时比较吞吐、错误率与尾延迟。只有热点面积变小但业务吞吐下降,不是有效优化。
sudo perf script > perf.script
stackcollapse-perf.pl perf.script > perf.folded
flamegraph.pl --title 'my-service CPU 60s' perf.folded > cpu.svg
wc -l perf.script perf.folded
grep -m 5 my-service perf.script
九、生产护栏与证据保存
所有脚本设置 timeout、过滤 PID 或 cgroup、限制 map key 基数。URL、用户 ID 等高基数字段不能直接作为 key。先单实例验证并记录探针 CPU、内存增量,再决定是否扩大范围。
sha256sum investigation.bt
date -Is; uname -r; bpftrace --version
sudo timeout 30 bpftrace investigation.bt > evidence.txt
printf 'exit=%s\n' "$?" >> evidence.txt
date -Is >> evidence.txt- 结果可能包含敏感栈和路径,按生产日志等级保护。
- 同一失败指纹没有前置条件变化时不要盲目重跑。
- 容器环境明确宿主 PID 与 namespace 映射。
十、验收清单
最终报告要能证明为什么选择该层探针、过滤条件是什么、观测窗口覆盖哪个慢请求、结论如何由直方图或栈支持,以及优化后是否在同负载复测。无法回答其中任何一项时,结论只能标为待验证。
- 基线证明瓶颈层级而非凭直觉。
- 探针有时限、权限、基数上限和回滚。
- 业务指标与内核证据处于同一时间窗口。
- 优化后相同负载复测且保留反证。
总结
eBPF 最有价值的用法是用最小探针回答一个明确问题。先建立分层基线,再选择稳定事件并限定范围,最后以同负载复测闭环,才能把低层观测转化为可审计的性能结论。