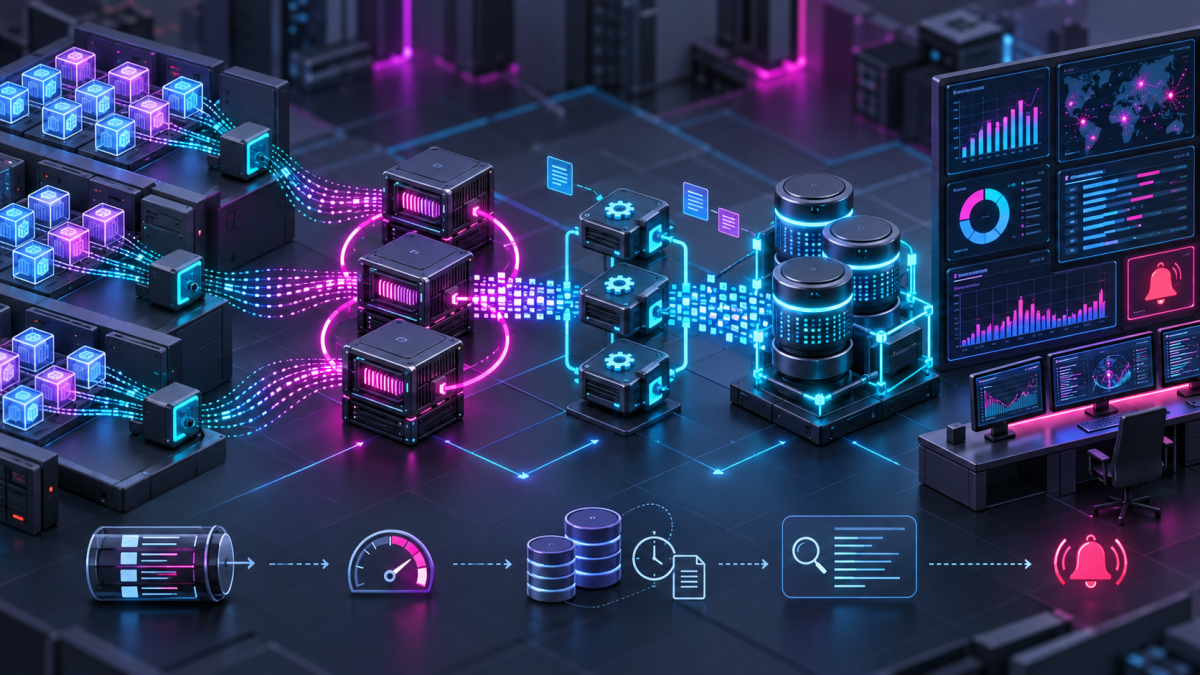
本文搭建一条可承受下游故障的 Kubernetes 日志链路:Filebeat DaemonSet 从每个节点采集容器日志,Kafka 负责缓冲与削峰,Logstash 消费、解析和清洗,Elasticsearch 保存并索引,Kibana 查询与可视化。示例使用 ECK 管理 Elasticsearch/Kibana、Strimzi 管理 KRaft Kafka,并明确每一段的验收和背压指标。
一、架构、交付目标与版本矩阵
/var/log/containers/*.log
        |  每节点 Filebeat DaemonSet(filestream + Kubernetes metadata)
        v
Kafka topic: kubernetes-logs(3 brokers,RF=3,削峰/重放)
        |  consumer group: logstash-k8s
        v
Logstash replicas(JSON 解析、字段规范、失败标记)
        |
        v
Elasticsearch data stream + lifecycle policy <-> Kibana Discover/Dashboard/Alert| 组件 | 本文角色 | 版本策略 |
|---|---|---|
| Filebeat | 节点采集与元数据 | 与 Elastic Stack 同一受支持主版本,固定镜像 |
| Kafka/Strimzi | 缓冲与重放 | 固定 operator;Kafka 版本取 operator 支持矩阵 |
| Logstash | 消费、解析、路由 | 与 Elasticsearch 同一受支持主版本 |
| Elasticsearch/Kibana/ECK | 存储与检索 | ECK 与 Stack 分别固定版本 |
Filebeat 9 已禁用旧
loginput,本文使用filestream。如果 Filebeat 输出 Kafka,内置 template、pipeline 和 dashboard 不会自动写入 Elasticsearch,必须单独管理 index/data stream 模板。
二、容量计算与前置检查
先采样一周:原始日志 GB/日、峰值 events/s、平均/最大事件大小、保留天数、可接受丢失窗口。粗略磁盘预算为“每日原始量 × 索引膨胀系数 × (副本数+1) × 保留天数 × 1.3 余量”;最终以实测压缩率为准。Kafka 容量还要覆盖 Elasticsearch 最长维护窗口。
kubectl create namespace logging --dry-run=client -o yaml | kubectl apply -f -
kubectl get nodes -o wide
kubectl get storageclass
kubectl top nodes

helm repo add elastic https://helm.elastic.co
helm repo add strimzi https://strimzi.io/charts/
helm repo update
helm search repo elastic/eck-operator -l | head
helm search repo strimzi/strimzi-kafka-operator -l | head
三、安装 ECK 并部署 Elasticsearch/Kibana
export ECK_CHART_VERSION='<经验证的版本>'
helm upgrade --install elastic-operator elastic/eck-operator \
  -n elastic-system --create-namespace \
  --version "$ECK_CHART_VERSION" --atomic --timeout 10m
kubectl -n elastic-system rollout status statefulset/elastic-operator --timeout=5m
apiVersion: elasticsearch.k8s.elastic.co/v1
kind: Elasticsearch
metadata: {name: logs, namespace: logging}
spec:
version: "<固定且受 ECK 支持的 Elastic 版本>"
nodeSets:
- name: masters
count: 3
config:
node.roles: [master]
podTemplate:
spec:
containers:
- name: elasticsearch
resources:
requests: {cpu: 500m, memory: 2Gi}
limits: {cpu: "2", memory: 2Gi}
- name: data
count: 3
config:
node.roles: [data, ingest, remote_cluster_client]
podTemplate:
spec:
containers:
- name: elasticsearch
resources:
requests: {cpu: "2", memory: 8Gi}
limits: {cpu: "4", memory: 8Gi}
volumeClaimTemplates:
- metadata: {name: elasticsearch-data}
spec:
accessModes: [ReadWriteOnce]
storageClassName: fast-rwo
resources: {requests: {storage: 500Gi}}
---
apiVersion: kibana.k8s.elastic.co/v1
kind: Kibana
metadata: {name: logs, namespace: logging}
spec:
version: "<与 Elasticsearch 完全相同的版本>"
count: 2
elasticsearchRef: {name: logs}
podTemplate:
spec:
containers:
- name: kibana
resources:
requests: {cpu: 300m, memory: 1Gi}
limits: {cpu: "2", memory: 2Gi}kubectl apply -f elastic-stack.yaml
kubectl -n logging get elasticsearch,kibana,pods,pvc
kubectl -n logging get secret logs-es-elastic-user -o go-template='{{.data.elastic | base64decode}}{{"\n"}}'
kubectl -n logging port-forward svc/logs-es-http 9200:9200
curl --cacert <(kubectl -n logging get secret logs-es-http-certs-public -o go-template='{{index .data "tls.crt" | base64decode}}') \
-u elastic:<PASSWORD> https://127.0.0.1:9200/_cluster/health?pretty生产环境不要把密码留在 shell history;上面的读取仅用于首次验证。应创建专用 Logstash 角色与用户,只允许写指定 data stream,并由 Secret 管理。ECK 自动创建 TLS,不要为了方便在生产关闭证书校验。
四、用 Strimzi 部署 KRaft Kafka
export STRIMZI_CHART_VERSION='<经验证的版本>'
helm upgrade --install strimzi strimzi/strimzi-kafka-operator \
  -n logging --version "$STRIMZI_CHART_VERSION" \
  --atomic --timeout 10m
kubectl -n logging rollout status deployment/strimzi-cluster-operator --timeout=5m
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaNodePool
metadata:
name: controllers
namespace: logging
labels: {strimzi.io/cluster: logs-kafka}
spec:
replicas: 3
roles: [controller]
storage:
type: persistent-claim
size: 20Gi
class: fast-rwo
deleteClaim: false
---
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaNodePool
metadata:
name: brokers
namespace: logging
labels: {strimzi.io/cluster: logs-kafka}
spec:
replicas: 3
roles: [broker]
storage:
type: persistent-claim
size: 500Gi
class: fast-rwo
deleteClaim: false
---
apiVersion: kafka.strimzi.io/v1beta2
kind: Kafka
metadata: {name: logs-kafka, namespace: logging}
spec:
kafka:
listeners:
- name: tls
port: 9093
type: internal
tls: true
authentication: {type: scram-sha-512}
config:
default.replication.factor: 3
min.insync.replicas: 2
offsets.topic.replication.factor: 3
transaction.state.log.replication.factor: 3
transaction.state.log.min.isr: 2
log.retention.hours: 72
log.message.timestamp.type: LogAppendTime
entityOperator:
topicOperator: {}
userOperator: {}现代 Strimzi 使用 KafkaNodePool;生产建议 controller 与 broker 分离。Kafka 具体版本应由已安装 Strimzi 的支持矩阵决定,不能凭文章硬编码。LogAppendTime 避免延迟到达的旧日志因事件时间早于保留窗口而被立即删除。
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaTopic
metadata:
  name: kubernetes-logs
  namespace: logging
  labels: {strimzi.io/cluster: logs-kafka}
spec:
  partitions: 24
  replicas: 3
  config:
    min.insync.replicas: 2
    retention.ms: 259200000
    cleanup.policy: delete
---
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaUser
metadata:
  name: filebeat
  namespace: logging
  labels: {strimzi.io/cluster: logs-kafka}
spec:
  authentication: {type: scram-sha-512}
  authorization:
    type: simple
    acls:
      - resource: {type: topic, name: kubernetes-logs, patternType: literal}
        operations: [Write, Describe]
        host: "*"
五、部署 Filebeat DaemonSet
5.1 核心配置
filebeat.autodiscover:
  providers:
    - type: kubernetes
      node: ${NODE_NAME}
      hints.enabled: true
      hints.default_config:
        type: filestream
        id: container-${data.kubernetes.container.id}
        prospector.scanner.symlinks: true
        parsers:
          - container: ~
        paths:
          - /var/log/containers/*-${data.kubernetes.container.id}.log
processors:
  - add_cloud_metadata: ~
  - add_host_metadata: ~
  - drop_event:
      when:
        equals:
          kubernetes.namespace: logging
output.kafka:
  hosts: ["logs-kafka-kafka-bootstrap.logging.svc:9093"]
  topic: kubernetes-logs
  version: "4.0.0"
  required_acks: -1
  compression: lz4
  max_message_bytes: 1000000
  username: ${KAFKA_USERNAME}
  password: ${KAFKA_PASSWORD}
  ssl.enabled: true
  ssl.certificate_authorities: ["/etc/kafka/ca/ca.crt"]
queue.mem:
  events: 8192
  flush.min_events: 1024
  flush.timeout: 5s
Kafka 4.x 时 Filebeat 的协议版本至少要设置为 2.1.0;这里的 4.0.0 必须与 Filebeat 当前支持范围和实际 broker 核对。max_message_bytes 大于该值的事件会被丢弃,必须与 broker/topic 限制一起设计并监控 dropped events。排除 logging namespace 是为了避免采集链路自身日志形成反馈洪水,实际可保留关键组件到单独 topic。
5.2 DaemonSet 关键挂载与权限
apiVersion: apps/v1
kind: DaemonSet
metadata: {name: filebeat, namespace: logging}
spec:
  selector: {matchLabels: {app: filebeat}}
  template:
    metadata: {labels: {app: filebeat}}
    spec:
      serviceAccountName: filebeat
      containers:
        - name: filebeat
          image: docker.elastic.co/beats/filebeat:<固定版本>
          args: ["-e", "-c", "/etc/filebeat.yml"]
          env:
            - name: NODE_NAME
              valueFrom: {fieldRef: {fieldPath: spec.nodeName}}
            - name: KAFKA_USERNAME
              value: filebeat
            - name: KAFKA_PASSWORD
              valueFrom: {secretKeyRef: {name: filebeat, key: password}}
          securityContext: {runAsUser: 0}
          volumeMounts:
            - {name: config, mountPath: /etc/filebeat.yml, subPath: filebeat.yml, readOnly: true}
            - {name: varlogcontainers, mountPath: /var/log/containers, readOnly: true}
            - {name: varlogpods, mountPath: /var/log/pods, readOnly: true}
            - {name: data, mountPath: /usr/share/filebeat/data}
            - {name: kafka-ca, mountPath: /etc/kafka/ca, readOnly: true}
      volumes:
        - name: varlogcontainers
          hostPath: {path: /var/log/containers}
        - name: varlogpods
          hostPath: {path: /var/log/pods}
        - name: data
          hostPath: {path: /var/lib/filebeat-data, type: DirectoryOrCreate}
还需要按 Filebeat 官方 Kubernetes manifest 创建只读 RBAC(nodes、namespaces、pods、leases)和 ConfigMap,并把 Strimzi 生成的 CA/用户 Secret 以最小字段复制或由秘密同步器提供。Filebeat registry 必须持久化到每个节点,否则 Pod 重建会导致重复采集。
六、部署 Logstash 消费与写入 data stream
input {
  kafka {
    bootstrap_servers => "logs-kafka-kafka-bootstrap.logging.svc:9093"
    topics => ["kubernetes-logs"]
    group_id => "logstash-k8s"
    consumer_threads => 6
    decorate_events => "basic"
    codec => json
    security_protocol => "SASL_SSL"
    sasl_mechanism => "SCRAM-SHA-512"
    sasl_jaas_config => "org.apache.kafka.common.security.scram.ScramLoginModule required username='${KAFKA_USERNAME}' password='${KAFKA_PASSWORD}';"
    ssl_truststore_location => "/usr/share/logstash/config/kafka.truststore.p12"
    ssl_truststore_password => "${KAFKA_TRUSTSTORE_PASSWORD}"
  }
}
filter {
  if [message] =~ /^\s*\{/ {
    json { source => "message" target => "app" tag_on_failure => ["_jsonparsefailure"] }
  }
  mutate {
    add_field => {
      "[data_stream][type]" => "logs"
      "[data_stream][dataset]" => "kubernetes.container"
      "[data_stream][namespace]" => "production"
    }
  }
}
output {
  elasticsearch {
    hosts => ["https://logs-es-http.logging.svc:9200"]
    user => "${ELASTIC_USERNAME}"
    password => "${ELASTIC_PASSWORD}"
    ssl_enabled => true
    ssl_certificate_authorities => ["/usr/share/logstash/config/es-ca.crt"]
    data_stream => true
    data_stream_auto_routing => true
  }
}
Logstash Deployment 至少两个副本,副本总 consumer_threads 不应长期大于 topic partition 数。开启 persistent queue 可缓冲短暂 Elasticsearch 故障,但不能替代 Kafka。为解析失败事件保留 _jsonparsefailure 标签并建立单独告警/视图,而不是静默删除。
七、端到端验收
# 1. 产生唯一测试日志
TRACE_ID="accept-$(date +%s)"
kubectl -n default run log-probe --restart=Never --image=busybox:<固定版本> \
  -- sh -c "echo '{\"level\":\"info\",\"message\":\"logging acceptance\",\"trace_id\":\"$TRACE_ID\"}'"

# 2. Filebeat 无输出错误
kubectl -n logging logs ds/filebeat --since=5m | tail -n 100

# 3. Kafka topic 有消息且 consumer group 无持续积压
kubectl -n logging exec logs-kafka-brokers-0 -- \
  bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 \
  --describe --group logstash-k8s

# 4. Elasticsearch 搜索唯一 trace_id
curl --cacert es-ca.crt -u "$ES_USER:$ES_PASS" \
  -H 'Content-Type: application/json' \
  https://127.0.0.1:9200/logs-kubernetes.container-production/_search \
  -d "{\"query\":{\"term\":{\"app.trace_id.keyword\":\"$TRACE_ID\"}}}"
验收必须保留同一个 TRACE_ID 在源 Pod、Filebeat、Kafka consumer group、Logstash 和 Elasticsearch 中的证据。只看到 Kibana 有其他日志,不能证明本次链路完整。
八、性能、生命周期与背压治理
- Filebeat:监控读取延迟、发布失败、活跃 harvester、registry 和丢弃事件;不要盲目增大内存队列。
- Kafka:监控 broker 磁盘、UnderReplicatedPartitions、ISR、produce 延迟和 consumer lag;保留期覆盖最长下游故障。
- Logstash:以 partition 数决定并行度,观察 events in/out、queue、批次耗时和 JVM GC;解析昂贵时拆 pipeline。
- Elasticsearch:控制 shard 数与字段数量,使用 data stream/lifecycle 滚动与删除,预留磁盘水位空间。
- Kibana:限制超大时间范围与高基数聚合,公共仪表盘使用稳定字段和保存查询。
PUT _ilm/policy/kubernetes-logs-30d
{
  "policy": {
    "phases": {
      "hot": {"actions": {"rollover": {"max_primary_shard_size": "50gb", "max_age": "1d"}}},
      "delete": {"min_age": "30d", "actions": {"delete": {}}}
    }
  }
}
策略创建后还需通过 composable index template 绑定到对应 data stream。修改生命周期前先确认合规保留要求;缩短保留期属于数据删除变更,应走审批。
九、故障排查与灾难恢复
| 现象 | 首查指标 | 判断 | 动作 |
|---|---|---|---|
| Kafka lag 上升 | consumer lag、Logstash out | 消费慢或 ES 慢 | 分层定位,不先加副本 |
| Filebeat 重复日志 | registry/Pod 重建 | registry 未持久或路径变更 | 恢复 data 路径并评估重放 |
| ES 429 | thread pool、磁盘水位 | 写入超载 | 限流 Logstash,扩容/降 shard |
| 解析失败突增 | _jsonparsefailure | 应用日志格式变化 | 保留原文,修 parser 后重放 |
| Kafka broker 不可用 | ISR/URP | 节点/磁盘/网络 | 先恢复 ISR,禁止强制不安全选主 |
备份范围包括 Elasticsearch 快照仓库与恢复演练、Kafka topic/ACL/operator 配置、Filebeat/Logstash ConfigMap 和 Secret 来源、ECK/Strimzi CR、Kibana saved objects。Kafka 不是永久归档,Elasticsearch snapshot 也不能由 PVC 快照简单替代。
十、生产验收清单
- 唯一 TRACE_ID 在五段链路可追踪,延迟满足 SLO。
- 停止 Elasticsearch 后 Kafka 能承接积压;恢复后 lag 在约定时间归零且无静默丢失。
- Kafka TLS/SCRAM、最小 ACL、Elasticsearch TLS 与专用写入角色均生效。
- 生命周期策略、磁盘水位、shard/字段上限、超大消息与解析失败均有告警。
- Filebeat registry 持久,DaemonSet 覆盖预期节点且不会采集自身形成反馈环。
- 完成 Elasticsearch 快照恢复和配置重建演练,记录 RPO/RTO。
十一、总结
这条链路的核心不是组件数量,而是可观测的背压边界:Filebeat 不能静默丢事件,Kafka 必须承接维护窗口,Logstash 要可重放,Elasticsearch 要受生命周期和水位保护。只有用唯一事件完成端到端验证,再演练下游停机与恢复,日志平台才真正可用于生产故障取证。