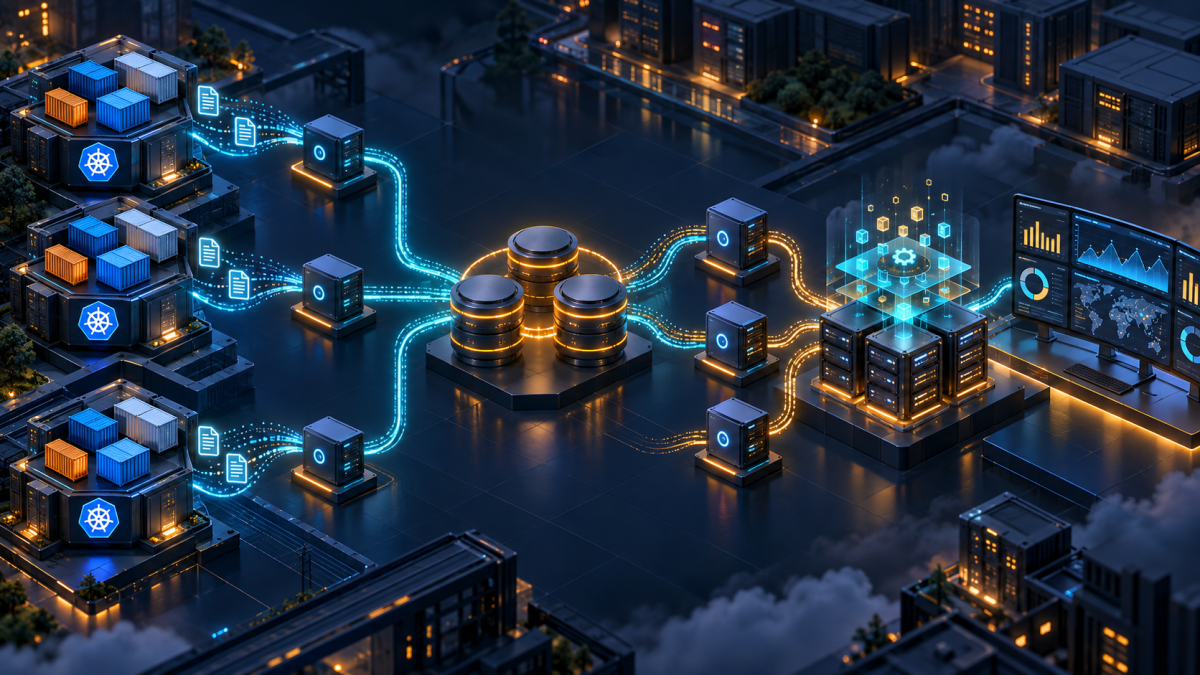
一、目标、边界与最终拓扑
本文搭建一条不含 Logstash 的生产型 Kubernetes 日志链路。节点上的 Filebeat 只负责可靠采集并写入 Kafka;消费侧使用独立 Filebeat 消费者组读取 Kafka,把事件交给 Elasticsearch Ingest Pipeline;Elasticsearch 在写入前完成 JSON 解码、字段规范化、时间校正、访问日志解析、失败标记与数据流路由;Kibana 用于检索、可视化和告警。
关键事实:Elasticsearch 本身不直接订阅 Kafka。去掉 Logstash 后仍需要消费者。本方案选择第二组 Filebeat 作为 Kafka 消费者,清洗逻辑集中到 Elasticsearch Ingest Pipeline,避免把解析规则散落在每个节点。
Kubernetes Pods -> node log files -> Filebeat DaemonSet
  -> Kafka topic: k8s.logs.raw (3+ partitions, replication)
  -> Filebeat Deployment consumer group: elastic-k8s-logs-v1
  -> Elasticsearch ingest pipeline: k8s-logs-v1
  -> data stream: logs-kubernetes.default
  -> Kibana data view / dashboards / alerting
二、上线前容量与可靠性设计
先用峰值而不是日均值设计。假设峰值 20,000 条/秒、平均事件 1.2 KiB、Kafka 保留 24 小时,则原始数据约 1.93 TiB;再计入副本因子 3、索引、页缓存和 30% 安全余量。Kafka 分区数至少覆盖消费并发,初始可设 12;消费者副本从 3 起步,每个副本只使用同一 group_id。
- 所有组件必须使用 TLS;Kafka 使用独立生产者/消费者凭据,Elasticsearch 使用最小权限 API Key。
- 采集端磁盘队列用于短时断网;Kafka 是跨节点缓冲,不把 Filebeat 内存队列当持久消息系统。
- 业务事件必须输出单行 JSON;多行堆栈只在采集端合并,避免进入 Kafka 后再猜测边界。
- 所有时间使用 UTC 和 RFC 3339;展示时由 Kibana 转换时区。
三、准备命名空间、Secret 与 Kafka Topic
kubectl create namespace observability
kubectl -n observability create secret generic kafka-filebeat-producer \
  --from-literal=username='filebeat-producer' \
  --from-literal=password='REPLACE_ME'
kubectl -n observability create secret generic kafka-filebeat-consumer \
  --from-literal=username='filebeat-consumer' \
  --from-literal=password='REPLACE_ME'
kubectl -n observability create secret generic elastic-filebeat \
  --from-literal=api-key='REPLACE_WITH_BASE64_ID_COLON_KEY'
生产环境应由 External Secrets、Vault 或云密钥服务下发,不要把真实密钥提交到 Git。Kafka Topic 建议显式创建并固定保留策略,防止自动建 Topic 使用错误副本数。
kubectl -n kafka exec -it kafka-0 -- bin/kafka-topics.sh \
  --bootstrap-server kafka-kafka-bootstrap:9093 \
  --create --topic k8s.logs.raw \
  --partitions 12 --replication-factor 3 \
  --config min.insync.replicas=2 \
  --config retention.ms=86400000 \
  --config cleanup.policy=delete

kubectl -n kafka exec kafka-0 -- bin/kafka-topics.sh \
  --bootstrap-server kafka-kafka-bootstrap:9093 \
  --describe --topic k8s.logs.raw
四、部署采集端 Filebeat DaemonSet
4.1 采集配置
filestream 的 container parser 能正确处理容器运行时日志封装。add_kubernetes_metadata 通过容器 ID 关联 Pod 元数据。只保留检索和路由需要的标签,避免动态标签造成 Elasticsearch 映射膨胀。
apiVersion: v1
kind: ConfigMap
metadata:
  name: filebeat-producer-config
  namespace: observability
data:
  filebeat.yml: |
    filebeat.inputs:
      - type: filestream
        id: kubernetes-container-logs
        enabled: true
        paths: [/var/log/containers/*.log]
        parsers:
          - container:
              stream: all
              format: auto
        prospector.scanner.symlinks: true
        close.on_state_change.removed: true
        processors:
          - add_kubernetes_metadata:
              host: ${NODE_NAME}
              matchers:
                - logs_path:
                    logs_path: /var/log/containers/
          - drop_fields:
              fields: [agent, ecs, host.mac, host.os, input]
              ignore_missing: true
    queue.disk:
      max_size: 10GB
      path: /usr/share/filebeat/data/diskqueue
      segment_size: 512MB
    output.kafka:
      hosts: [kafka-kafka-bootstrap.kafka.svc:9093]
      topic: k8s.logs.raw
      key: '%{[kubernetes.namespace]}:%{[kubernetes.pod.name]}'
      partition.hash:
        hash: [kubernetes.namespace, kubernetes.pod.name]
      required_acks: -1
      compression: lz4
      max_message_bytes: 10485760
      version: '3.6.0'
      ssl.enabled: true
      ssl.certificate_authorities: [/etc/kafka-ca/ca.crt]
      sasl.mechanism: SCRAM-SHA-512
      username: ${KAFKA_USERNAME}
      password: ${KAFKA_PASSWORD}
    logging.json: true
    monitoring.enabled: true
4.2 DaemonSet 的关键安全设置
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: filebeat-producer
  namespace: observability
spec:
  selector:
    matchLabels: {app: filebeat-producer}
  template:
    metadata:
      labels: {app: filebeat-producer}
    spec:
      serviceAccountName: filebeat
      terminationGracePeriodSeconds: 30
      containers:
        - name: filebeat
          image: docker.elastic.co/beats/filebeat:9.1.4
          args: ['-e', '-c', '/etc/filebeat.yml']
          securityContext:
            runAsUser: 0
            readOnlyRootFilesystem: true
            allowPrivilegeEscalation: false
          resources:
            requests: {cpu: 100m, memory: 200Mi}
            limits: {cpu: '1', memory: 800Mi}
          env:
            - name: NODE_NAME
              valueFrom: {fieldRef: {fieldPath: spec.nodeName}}
            - name: KAFKA_USERNAME
              valueFrom: {secretKeyRef: {name: kafka-filebeat-producer, key: username}}
            - name: KAFKA_PASSWORD
              valueFrom: {secretKeyRef: {name: kafka-filebeat-producer, key: password}}
          volumeMounts:
            - {name: config, mountPath: /etc/filebeat.yml, subPath: filebeat.yml, readOnly: true}
            - {name: varlog, mountPath: /var/log, readOnly: true}
            - {name: data, mountPath: /usr/share/filebeat/data}
      volumes:
        - name: config
          configMap: {name: filebeat-producer-config}
        - name: varlog
          hostPath: {path: /var/log}
        - name: data
          hostPath: {path: /var/lib/filebeat-data, type: DirectoryOrCreate}
五、在 Elasticsearch 创建模板与 Ingest Pipeline
5.1 字段模板与数据流
curl --fail --cacert ca.crt -H "Authorization: ApiKey $ES_API_KEY" \
  -H 'Content-Type: application/json' -X PUT "$ES_URL/_component_template/logs-k8s-mappings" -d @- <<'JSON'
{
  "template": {"mappings": {"dynamic": true, "properties": {
    "@timestamp": {"type": "date"},
    "trace.id": {"type": "keyword"},
    "log.level": {"type": "keyword"},
    "http.response.status_code": {"type": "integer"},
    "event.duration": {"type": "long"},
    "kubernetes.namespace": {"type": "keyword"},
    "kubernetes.pod.name": {"type": "keyword"},
    "message": {"type": "match_only_text"}
  }}}
}
JSON

curl --fail --cacert ca.crt -H "Authorization: ApiKey $ES_API_KEY" \
  -H 'Content-Type: application/json' -X PUT "$ES_URL/_index_template/logs-k8s" -d @- <<'JSON'
{
  "index_patterns": ["logs-kubernetes-*"],
  "data_stream": {},
  "priority": 500,
  "composed_of": ["logs-k8s-mappings"],
  "template": {"settings": {"index.default_pipeline": "k8s-logs-v1"}}
}
JSON
5.2 清洗、格式化与失败处理
先复制原始消息,再有条件地解析 JSON。业务已输出 JSON 时将字段放入 app,随后把稳定字段重命名为 ECS;非 JSON 的 Nginx 访问日志走 grok;任何处理器失败都写入 error.message 和 tags,而不是静默丢弃。
PUT _ingest/pipeline/k8s-logs-v1
{
  "description": "Kubernetes logs: JSON/Nginx parsing and ECS normalization",
  "processors": [
    {"set": {"field": "event.original", "copy_from": "message", "override": false}},
    {"json": {"field": "message", "target_field": "app", "add_to_root": false,
      "if": "ctx.message != null && ctx.message.trim().startsWith('{')", "ignore_failure": true}},
    {"rename": {"field": "app.level", "target_field": "log.level", "ignore_missing": true}},
    {"rename": {"field": "app.trace_id", "target_field": "trace.id", "ignore_missing": true}},
    {"date": {"field": "app.timestamp", "target_field": "@timestamp",
      "formats": ["ISO8601", "UNIX_MS"], "if": "ctx.app?.timestamp != null", "ignore_failure": true}},
    {"grok": {"field": "message",
      "patterns": ["%{IPORHOST:source.address} - %{DATA:user.name} \\[%{HTTPDATE:nginx.time}\\] \\\"%{WORD:http.request.method} %{DATA:url.original} HTTP/%{NUMBER:http.version}\\\" %{NUMBER:http.response.status_code:int} %{NUMBER:http.response.body.bytes:long} %{QS:http.request.referrer} %{QS:user_agent.original}"],
      "if": "ctx.app == null && ctx.message != null && ctx.message.contains('HTTP/')", "ignore_failure": true}},
    {"date": {"field": "nginx.time", "target_field": "@timestamp",
      "formats": ["dd/MMM/yyyy:HH:mm:ss Z"], "if": "ctx.nginx?.time != null", "ignore_failure": true}},
    {"set": {"field": "event.dataset", "value": "kubernetes.container"}},
    {"set": {"field": "data_stream.type", "value": "logs"}},
    {"set": {"field": "data_stream.dataset", "value": "kubernetes"}},
    {"set": {"field": "data_stream.namespace", "value": "default"}},
    {"remove": {"field": ["nginx.time"], "ignore_missing": true}}
  ],
  "on_failure": [
    {"set": {"field": "error.message", "value": "{{ _ingest.on_failure_message }}"}},
    {"append": {"field": "tags", "value": "ingest_failure"}}
  ]
}
六、先模拟 Pipeline,再部署 Kafka 消费者
POST _ingest/pipeline/k8s-logs-v1/_simulate
{
  "docs": [
    {"_source": {"message": "{\"timestamp\":\"2026-09-26T03:20:00Z\",\"level\":\"INFO\",\"trace_id\":\"abc-123\",\"msg\":\"paid\"}"}},
    {"_source": {"message": "10.0.0.8 - - [26/Sep/2026:11:20:00 +0800] \"GET /health HTTP/1.1\" 200 18 \"-\" \"curl/8.0\""}}
  ]
}
确认 @timestamp、trace.id、http.response.status_code 类型正确后再启动消费者。消费者的 pipeline 配置会把每个事件送入同一 Ingest Pipeline;group_id 相同才能在副本间分摊分区。
filebeat.inputs:
  - type: kafka
    hosts: [kafka-kafka-bootstrap.kafka.svc:9093]
    topics: [k8s.logs.raw]
    group_id: elastic-k8s-logs-v1
    client_id: ${HOSTNAME}
    initial_offset: oldest
    version: '3.6.0'
    pipeline: k8s-logs-v1
    ssl.enabled: true
    ssl.certificate_authorities: [/etc/kafka-ca/ca.crt]
    username: ${KAFKA_USERNAME}
    password: ${KAFKA_PASSWORD}
    sasl.mechanism: SCRAM-SHA-512

output.elasticsearch:
  hosts: ['https://elasticsearch-es-http.elastic.svc:9200']
  api_key: ${ELASTIC_API_KEY}
  ssl.certificate_authorities: [/etc/es-ca/ca.crt]
  index: logs-kubernetes-default

setup.ilm.enabled: false
setup.template.enabled: false
queue.mem.events: 8192
bulk_max_size: 1600
把该配置挂载到 Deployment,副本数不应大于可用分区数。设置 PodDisruptionBudget、反亲和和拓扑分布,让多个消费者不落在同一节点。滚动升级时 maxUnavailable=1,避免整个消费组同时重平衡。
七、端到端验收
# 1. 生成唯一测试事件
TRACE_ID="log-e2e-$(date +%s)"
kubectl -n demo run log-probe --restart=Never --image=busybox:1.36 \
  -- sh -c "echo '{\"timestamp\":\"$(date -u +%FT%TZ)\",\"level\":\"INFO\",\"trace_id\":\"'$TRACE_ID'\",\"msg\":\"pipeline-ok\"}'"

# 2. 观察消费者组积压
kubectl -n kafka exec kafka-0 -- bin/kafka-consumer-groups.sh \
  --bootstrap-server kafka-kafka-bootstrap:9093 \
  --describe --group elastic-k8s-logs-v1

# 3. 在 Elasticsearch 查询唯一 trace
curl --fail --cacert ca.crt -H "Authorization: ApiKey $ES_API_KEY" \
"$ES_URL/logs-kubernetes-default/_search?q=trace.id:$TRACE_ID&pretty"- 确认每个节点有且只有一个采集 Pod,且 registry/disk queue 目录可写。
- 确认 Kafka Topic 的 ISR 与副本数正常,消费组 LAG 在稳定负载下趋近于零。
- 确认查询结果只有一条,@timestamp、Kubernetes 元数据和业务字段均存在。
- 在 Kibana 创建 logs-kubernetes-* Data View,以 @timestamp 为时间字段,再保存延迟、错误率和消费积压看板。
八、故障定位与性能调优
- Kafka LAG 持续增长:先区分生产速度突增、消费者 CPU 饱和、ES 429 或 Ingest Pipeline 处理过重;不要只盲目增加消费者。
- Elasticsearch 出现 429:降低 bulk_max_size、增加退避,检查写入线程池、磁盘水位和分片数量。
- 字段映射爆炸:关闭不受控对象的 dynamic,给业务扩展字段使用 flattened,严格限制 Kubernetes labels。
- 重复事件:Filebeat/Kafka 是至少一次语义,下游用稳定 event.id 或业务幂等键去重;不要承诺绝对 exactly-once。
- Pipeline CPU 高:先用 ingest processor stats 定位,再把昂贵脚本改为 dissect/grok 条件分支或由应用直接输出 JSON。
curl -s --cacert ca.crt -H "Authorization: ApiKey $ES_API_KEY" \
  "$ES_URL/_nodes/stats/ingest?filter_path=nodes.*.ingest.pipelines.*"
curl -s --cacert ca.crt -H "Authorization: ApiKey $ES_API_KEY" \
  "$ES_URL/_cat/thread_pool/write?v&h=node_name,active,queue,rejected,completed"
九、升级、回滚与数据安全
所有配置和 Pipeline 都要版本化。升级顺序为:新建 k8s-logs-v2 → simulate 回归样本 → 让一个 canary 消费者使用新 group 和测试 Topic → 小流量验证 → 切换生产消费者 pipeline → 保留 v1 至少一个保留周期。回滚只需恢复消费者的 pipeline 名称,不要覆盖旧 Pipeline。Kafka 凭据和 ES API Key 定期轮换,快照策略必须经过恢复演练。
十、完成标准与总结
完成不是“页面能搜到日志”,而是采集不丢行、Kafka 可缓冲、字段可预测、解析失败可观测、消费积压有告警、索引生命周期可控、变更可回滚。本文架构把传输、缓冲和清洗职责分离,在不引入 Logstash 的前提下仍保留了生产系统所需的可靠性与治理能力。