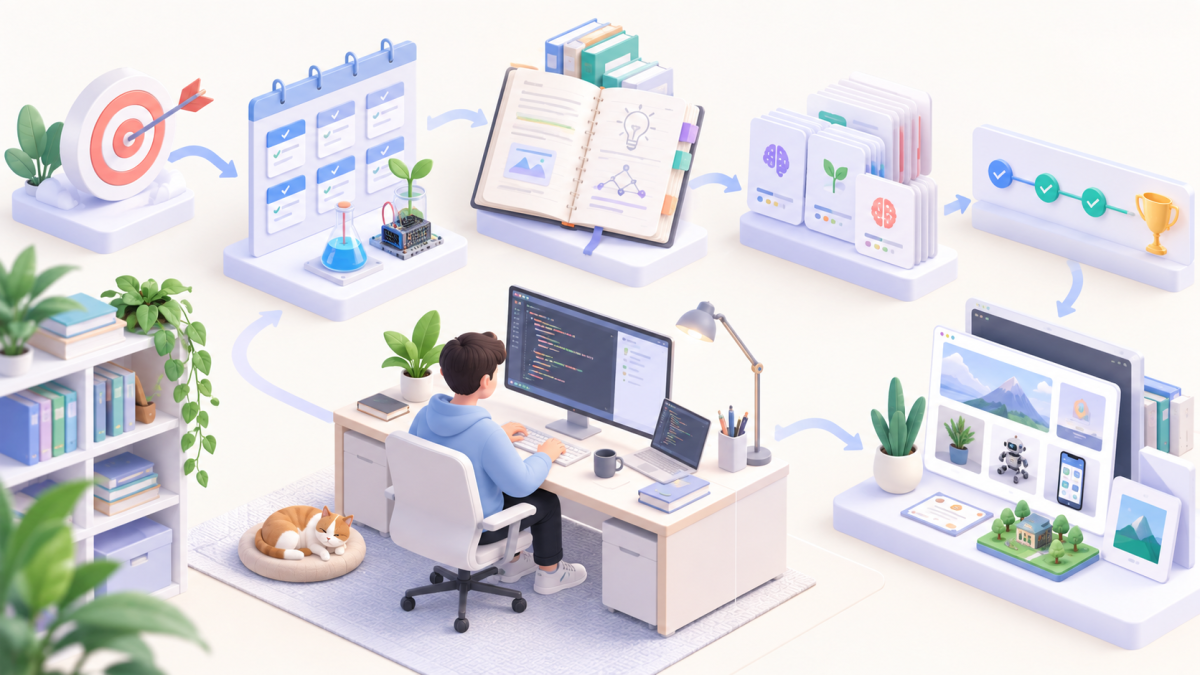
一、先定义学习系统的输出
收藏资料、看完课程和连续打卡都不是能力证明。一个可持续系统要把“我想学会”改写为可观察结果:能在干净环境复现、能解释关键权衡、能处理常见故障,并能留下别人可运行的作品。
先写清楚为什么现在学习、完成后能解决什么真实问题、证据由谁复查以及何时停止。退出条件能防止无限扩展范围,也能让你在方向不再有价值时及时止损。
方向:业务问题与能力缺口
  ↓
项目:可运行作品与验收标准
  ↓
本周:可复查实验与文档
  ↓
今天:30~90 分钟下一动作
  ↓
反馈:测试、他人复现、复盘 → 调整方向
二、建立能力地图和完成标准
以“掌握 Kubernetes”为例,不用课程章节做地图,而按部署、网络、存储、调度、排障、安全和交付拆成能力域。每个能力域至少设计一个正常路径和一个故障路径。
完成标准必须包含环境版本、输入、预期输出、失败证据和回滚。仅有命令没有解释不算完成,仅有概念没有运行证据也不算完成。
goal: 独立维护三节点测试集群
deadline: 2026-12-31
evidence:
  - 从零安装并记录前置检查
  - 注入 DNS、证书和磁盘压力故障
  - 用指标证明修复前后差异
exit_criteria:
  - 同事仅按文档即可复现
  - 所有命令、版本、验证和回滚完整
三、把大目标切成最小可验证实验
每个实验使用“假设—操作—观察—解释—下一步”五段式,一次只改变一个变量。命令前记录环境,命令后保存原始输出,失败也保留,这样才能区分知识错误、环境差异和操作遗漏。
实验时间盒到期仍无结论时,先写当前事实和未验证假设,再缩小范围。不要为追求绿色结果删除失败记录,因为错误路径往往比成功命令更能帮助下一位读者。
## 实验:验证容器内存限制
- 环境:Ubuntu 24.04 / Docker 27.x
- 假设:RSS 超过 128MiB 后出现 OOMKilled
- 操作:限制内存并施加固定负载
- 观察:退出码、inspect、内核日志
- 解释:对应 cgroup 文件与计数器
- 回滚:删除容器、镜像和临时数据
- 下一步:比较 reservation 与 hard limit
四、建立可检索而不是可观赏的笔记
每条笔记只回答一个可搜索问题,标题用实际排障时会输入的措辞。正文包含上下文、可靠结论、适用边界、验证命令和官方来源,避免只复制终端输出或只留下脱离版本的结论。
概念、运行手册、故障记录、实验和架构决策分开存放。稳定知识进入概念库,随环境变化的命令进入运行手册,失败时间线进入事故记录;同一事实只保留一个权威位置。
notes/
├── concepts/      稳定概念与反例
├── runbooks/      部署、升级、恢复步骤
├── experiments/   假设、原始输出、结论
├── incidents/     故障时间线与根因
└── decisions/     ADR:选择、替代项、后果
五、用 Git 保存知识演进和证据
笔记和实验脚本放入版本控制,提交粒度对应一次认知变化。提交正文解释为什么修改、证据在哪里、哪些边界仍未验证。二进制大文件放对象存储,仓库只保存可追溯链接和校验值。
git init learning-notes
cd learning-notes
mkdir -p concepts runbooks experiments incidents decisions
printf '# Evidence-based Learning Notes\n' > README.md
git add README.md concepts runbooks experiments incidents decisions
git commit -m 'docs: initialize evidence-based learning system'
git log --oneline --decorate -5
六、主动回忆与间隔复习
复习前先在不看答案的情况下解释概念、写出命令或画出数据流,再和原记录比较。卡片只承载稳定且值得长期记忆的知识;经常变化的参数应保留官方链接和实验环境,而不是死记。
一张好卡片包含问题、最小答案、一个反例和来源。例如“为什么索引不能无限增加”应回答写放大、缓存占用和优化器代价,而不是复制整篇数据库文章。
- 当天回忆实验结论和失败原因。
- 一周后从空白重新写关键命令并验证。
- 一个月后用不同环境迁移方法,检查是否真正理解边界。
七、每周复盘用数据调整计划
固定 30 分钟审查交付证据,不评价“努力程度”。统计完成实验数、被他人复现的文档数、故障恢复时间和反复延期任务。连续两周没有可验证产出的主题要缩小范围或暂停。
## 周复盘
1. 本周交付:链接、测试输出、截图
2. 最重要的新模型:一句话解释与反例
3. 最大阻塞:知识、环境、时间还是范围
4. 删除什么:不再服务目标的资料与任务
5. 下周唯一主线:一个可验证结果
6. 随机复现:从空环境执行一篇手册
八、让作品成为最严格反馈
作品不必巨大,但必须有 README、版本锁定、启动命令、验证命令、已知限制和回滚路径。请另一位同事只看文档复现,并记录他们在哪里停住;任何需要口头补充的步骤都是文档缺陷。
git clone <repository-url> /tmp/learning-verify
cd /tmp/learning-verify
git rev-parse --short HEAD
docker compose config --quiet
docker compose up -d --build
docker compose ps
curl --fail --retry 10 http://localhost:8080/health
docker compose down -v
九、常见失败与纠偏
资料越存越多时,每个主题只保留一份主教材、官方文档和问题清单。教程能照做但不会迁移时,主动改变操作系统、数据规模或故障条件并解释差异。计划持续延期时先缩小交付物,不能删除验证步骤。
如果只学不输出,规定每周至少完成一个可运行实验或一篇可复现手册。若输出只追求篇数,则随机抽查复现成功率,把“别人能否执行”放在字数之前。
- 不以收藏数量衡量进度。
- 不把一次成功当成理解边界。
- 不在没有版本和输入的情况下保存结论。
- 不因为实验失败而删除原始证据。
十、四周落地计划与验收
第 1 周选择一个真实问题,建立能力地图和完成标准;第 2 周完成三个最小实验;第 3 周整理成可运行作品并加入故障与回滚;第 4 周请他人从空环境复现并修复文档断点。
最终验收不是“我觉得懂了”,而是作品可运行、解释能回答反例、故障可恢复、文档被第三方复现。下一阶段只从这些证据暴露的缺口产生,不从推荐列表盲目扩张。
总结
高效学习的核心是缩短“提出假设—动手验证—获得反馈—修正模型”的周期。能力地图负责方向,实验负责证据,主动回忆负责保持,作品和他人复现负责检验。每周持续留下可复查交付物,学习就会从情绪驱动转为长期积累。